Es ist Dienstagmorgen, kurz nach acht. Im Projektraum stehen noch halbvolle Kaffeetassen vom Vorabend. Auf dem großen Bildschirm leuchtet eine Liste mit offenen Punkten: zwölf rot, sieben gelb, drei grün.
Vor sechs Wochen hatte ein Zulieferer überraschend angekündigt, ein zentrales Bauteil nicht mehr liefern zu können. Kein exotisches Teil, sondern eine Komponente, um die herum über Jahre ein erheblicher Teil der Elektronik entwickelt worden war. Der Ersatz war auf dem Papier schnell gefunden. In der Realität passte weder das Timing noch das thermische Verhalten, mehrere Schnittstellen mussten angepasst werden und plötzlich zeigte sich, wie viele vermeintlich unabhängige Entscheidungen der vergangenen Jahre an diesem einen Bauteil hingen.
Seitdem arbeitet das Team im Krisenmodus.
Die Hardwareentwickler haben ein neues Boardlayout erstellt. Die Embedded-Entwickler schreiben Treiber um. Der Einkauf hat einen alternativen Lieferanten gefunden. Das Testteam fährt zusätzliche Nachtschichten und der Projektleiter hat gemeinsam mit dem Kunden einen neuen Meilensteinplan ausgehandelt.
Heute sieht es erstmals wieder gut aus.
„Ich glaube, wir haben es geschafft“, sagt der Entwicklungsleiter und zeigt auf die letzten drei roten Punkte. „Wenn nichts Neues dazukommt, sind wir nächste Woche wieder auf Kurs.“
Erleichterung im Raum.
Und völlig zu Recht. Das Team hat unter enormem Druck funktioniert. Menschen haben Verantwortung übernommen, improvisiert, Prioritäten verschoben und Lösungen gefunden, die wenige Wochen zuvor niemand für möglich gehalten hätte.
Das Unternehmen hat gezeigt, dass es resilient ist.
Nur: Ist „wieder auf Kurs“ wirklich das richtige Ziel?
Denn während das Team versucht, zum ursprünglichen Plan zurückzukehren, hat sich die Welt außerhalb des Projektraums längst weiterbewegt. Ein Wettbewerber arbeitet mit einer anderen Architektur. Ein wichtiger Kunde stellt seine Anforderungen infrage. Neue regulatorische Vorgaben zeichnen sich ab. Und einige der technischen Entscheidungen, die gerade mit großem Aufwand gerettet wurden, stammen aus einer Zeit, in der die Rahmenbedingungen noch ganz andere waren.
Vielleicht besteht die eigentliche Herausforderung also gar nicht darin, möglichst schnell zum Zustand vor der Störung zurückzukehren.
Vielleicht ist genau dieser Wunsch das Problem.
In einer von VUCA und BANI geprägten Welt sind Störungen keine seltenen Ausnahmeereignisse mehr. Technologische Sprünge, Lieferkettenprobleme, geopolitische Veränderungen, neue Wettbewerber und unerwartete Kundenanforderungen gehören zum normalen Umfeld eines Deep-Tech-Unternehmens.
Resilienz ist darin zweifellos wichtig. Ein Unternehmen muss Schocks verkraften können, ohne daran zu zerbrechen.
Aber was, wenn es nicht nur Schocks aushalten, sondern aus ihnen besser werden könnte?
Fragilität – wenn kleine Störungen große Folgen haben
In einer stabilen und weitgehend vorhersehbaren Welt können wir Systeme optimieren. Wir analysieren Abläufe, reduzieren Bestände, eliminieren Redundanzen, standardisieren Prozesse und versuchen, möglichst genau vorherzusagen, welche Ressourcen wann benötigt werden. Solange sich die Umwelt ungefähr so verhält wie erwartet, funktioniert das ausgesprochen gut.
Das Problem beginnt dort, wo diese Voraussetzung nicht mehr gilt.
Genau darauf verweist das Konzept BANI, das bereits im Beitrag “Alles VUCA?” beschrieben wurde. Das „B“ steht dabei für brittle – brüchig oder fragil.
Ein fragiles System kann von außen durchaus stabil aussehen.
Es funktioniert vielleicht über Jahre hervorragend. Prozesse laufen effizient, Termine werden eingehalten, Kosten sinken und Kennzahlen entwickeln sich in die gewünschte Richtung. Gerade weil das System so gut funktioniert, gibt es zunächst wenig Anlass, seine grundlegende Konstruktion infrage zu stellen.
Bis etwas passiert, das in den Annahmen des Systems nicht vorgesehen war.
Ein Zulieferer fällt aus. Ein Bauteil wird abgekündigt. Eine neue Technologie verändert innerhalb kurzer Zeit die Erwartungen der Kunden. Ein zentraler Experte verlässt das Unternehmen. Eine regulatorische Änderung zwingt zu einer Anpassung der Produktarchitektur. Oder mehrere für sich genommen beherrschbare Ereignisse treten gleichzeitig auf.
Plötzlich zeigt sich, dass die scheinbare Stabilität auf Voraussetzungen beruhte, die niemand mehr bewusst wahrgenommen hat.
Genau das ist eine typische Eigenschaft komplexer Systeme.
Ihre Elemente sind nicht unabhängig voneinander, sondern über zahlreiche Rückkopplungen und Abhängigkeiten miteinander verbunden. Eine Veränderung an einer Stelle kann deshalb Auswirkungen an völlig anderen Stellen erzeugen. Ursache und Wirkung stehen dabei nicht zwangsläufig in einem einfachen proportionalen Verhältnis zueinander.
Eine kleine Ursache kann eine kleine Wirkung haben.
Sie kann aber auch eine Kaskade auslösen.
In einem technischen System kennen wir dieses Phänomen gut. Eine scheinbar geringfügige Änderung eines Bauteils beeinflusst vielleicht das Timing einer Schnittstelle. Dadurch verändert sich das Verhalten der Firmware. Ein zuvor stabiler Regelkreis beginnt unter bestimmten Randbedingungen zu schwingen. Ein Test schlägt sporadisch fehl. Der Zeitplan verschiebt sich, zusätzliche Entwickler werden aus einem anderen Projekt abgezogen und plötzlich gerät auch dieses Projekt unter Druck.
Aus einem kleinen technischen Problem ist ein organisatorisches Problem geworden.
Nicht weil jemand einen Fehler gemacht hätte, sondern weil das System gekoppelt ist.
Je dichter solche Abhängigkeiten werden, desto schwieriger wird es, alle möglichen Folgen einer Veränderung vorherzusehen. In komplexen Systemen kennen wir niemals sämtliche Zustände, Wechselwirkungen und zukünftigen Entwicklungen. Wir können Modelle erstellen, Szenarien entwickeln und Wahrscheinlichkeiten abschätzen – aber wir können die Unsicherheit nicht vollständig aus dem System herausplanen.
Fragilität entsteht deshalb insbesondere dort, wo wir ein komplexes System so behandeln, als wäre es vollständig vorhersehbar.
Das geschieht in Unternehmen erstaunlich leicht.
Wir reduzieren Lagerbestände, weil sie Kapital binden. Wir reduzieren freie Kapazitäten, weil ihre Auslastung zu gering erscheint. Wir konsolidieren Lieferanten, um Einkaufskonditionen zu verbessern. Wir vereinheitlichen technische Plattformen, um Entwicklungsaufwand zu sparen. Wir zentralisieren Wissen bei besonders leistungsfähigen Spezialisten. Wir synchronisieren Projekte immer genauer, damit keine Ressource ungenutzt bleibt.
Jede einzelne dieser Entscheidungen kann wirtschaftlich vollkommen sinnvoll sein.
In ihrer Summe können sie jedoch etwas erzeugen, das in keiner einzelnen Kennzahl sichtbar wird:
Fragilität.
Denn Effizienz entsteht häufig dadurch, dass Puffer, Alternativen und Redundanzen aus einem System entfernt werden. Unter normalen Bedingungen erhöht das seine Leistungsfähigkeit. Gleichzeitig kann dadurch seine Fähigkeit sinken, unerwartete Veränderungen aufzunehmen.
Das ist einer der Gründe, weshalb hochoptimierte Organisationen paradoxerweise besonders verwundbar sein können.
Ein System, das nur unter einem engen Satz erwarteter Bedingungen hervorragend funktioniert, ist nicht zwangsläufig robust. Es ist möglicherweise lediglich perfekt an die Vergangenheit angepasst.
Und genau hier liegt die besondere Herausforderung einer VUCA- oder BANI-Welt.
Je dynamischer das Umfeld wird, desto unwahrscheinlicher ist es, dass die Annahmen von gestern auch morgen noch gelten. Fragilität zeigt sich deshalb oft nicht im Normalbetrieb. Sie bleibt verborgen, bis das System mit etwas konfrontiert wird, das außerhalb seines vorgesehenen Betriebsbereichs liegt.
Man könnte Fragilität deshalb auch so beschreiben:
Ein fragiles System wird durch Abweichungen von seinen Erwartungen schlechter.
Je größer die Störung, desto größer der mögliche Schaden. Und in komplexen Systemen können selbst kleine Störungen unerwartet große Auswirkungen entwickeln.
Die entscheidende Managementfrage lautet damit nicht mehr nur:
Wie können wir verhindern, dass etwas Unerwartetes passiert?
Denn in einer komplexen Welt wird immer etwas Unerwartetes passieren.
Die interessantere Frage lautet:
Wie müssen wir Organisationen gestalten, damit das Unerwartete sie nicht zerbrechen lässt?
Damit kommen wir zur Robustheit und Resilienz.
Robustheit und Resilienz – die Fähigkeit, trotz Störung handlungsfähig zu bleiben
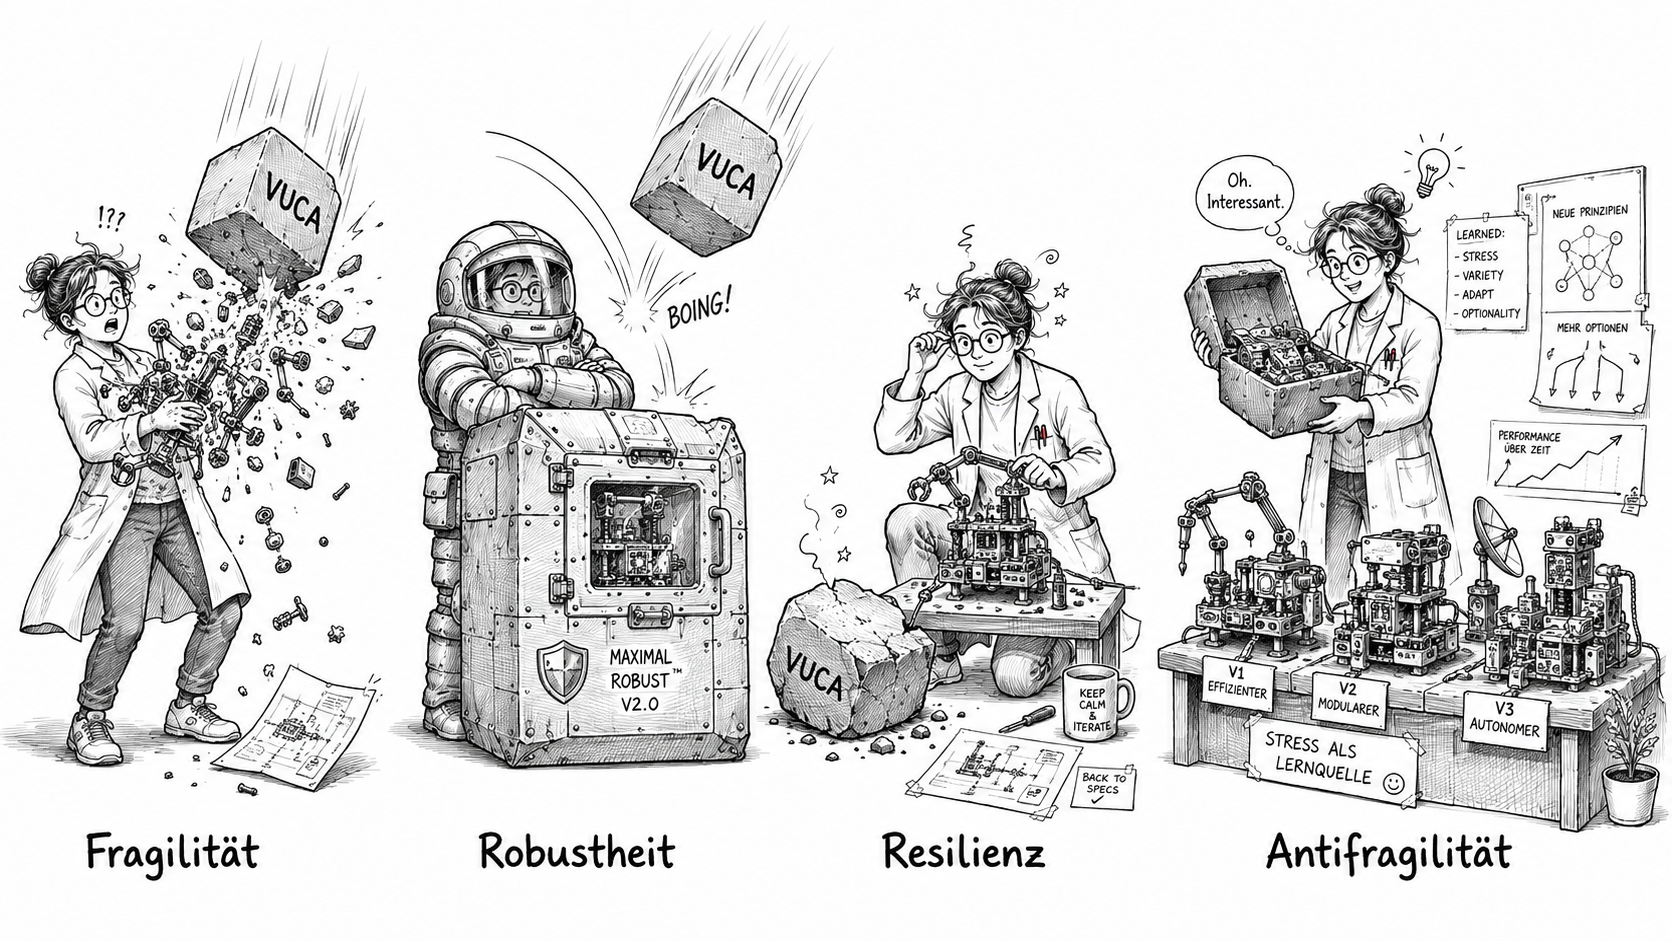
Ein robustes System begegnet Störungen, Erschütterungen und Schocks mit kompromissloser Härte und Unbiegsamkeit. Eine physikalische Metapher ist hierfür eine Küstenmauer (Wellenbrecher) [Pisar2026]. Sie verändert ihre Form über die Zeit nicht und trotzt den Wellen starr an Ort und Stelle.
Robustheit schützt vor Veränderung, ist aber starr und alterungsanfällig. Da ein robustes System sich nicht anpassen kann, neigt es dazu, bei einem Schock, der seine Belastungsgrenze überschreitet, abrupt und mit katastrophalen Folgen zu brechen. [Pisar2026]
Etwas besser schlägt sich ein resilientes System: Es begegnet Erschütterungen nicht mit sturer Gegenwehr, sondern mit Biegsamkeit und Elastizität.
Der Begriff Resilienz begegnet uns inzwischen fast überall. Menschen sollen resilient sein, Teams sollen resilient werden, Lieferketten, Organisationen und ganze Volkswirtschaften ebenfalls. Gerade in einer von VUCA und BANI geprägten Welt erscheint Resilienz zunächst wie die naheliegende Antwort auf zunehmende Unsicherheit: Wenn wir Störungen nicht verhindern können, müssen wir zumindest lernen, besser mit ihnen umzugehen.
Der Begriff selbst wird in unterschiedlichen Disziplinen etwas unterschiedlich verwendet. Gemeinsamer Kern ist jedoch die Fähigkeit von Personen, Gemeinschaften oder Systemen, schwierige Lebenssituationen, Krisen oder katastrophale Schocks ohne dauerhafte Beeinträchtigung zu überstehen.
Ein anschauliches Bild dafür ist eine Feder. Wird sie belastet, verformt sie sich. Nimmt man die Belastung weg, kehrt sie in ihre ursprüngliche Form zurück. Diese Vorstellung des „Zurückfederns“ steckt auch im englischen to bounce back und prägt einen Teil unseres intuitiven Verständnisses von Resilienz.
Auf Organisationen übertragen bedeutet das zunächst: Ein Unternehmen gerät durch ein unerwartetes Ereignis unter Druck, bleibt aber grundsätzlich funktionsfähig. Ein Lieferant fällt aus, ein Entwicklungsprojekt scheitert, ein wichtiger Mitarbeiter verlässt das Unternehmen oder ein neuer Wettbewerber verändert plötzlich den Markt. Prozesse geraten ins Stocken, Pläne müssen angepasst und Ressourcen neu verteilt werden. Eine resiliente Organisation schafft es dennoch, die Situation zu stabilisieren und wieder handlungsfähig zu werden.
In der modernen Managementliteratur wird das klassische Resilienz-Paradigma jedoch oft als inhärent reaktiv kritisiert. Da es das primäre Ziel der Resilienz ist, so schnell wie möglich in den vorherigen Zustand zurückzukehren, verharren Organisationen in einer defensiven Haltung. Sie laufen Gefahr, den Marktführern, die den Wandel proaktiv gestalten, immer einen Schritt hinterherzuhinken [Krings-Klebe2025].
Der Managementberater Thomas Pisar [Pisar2026] veranschaulicht dies durch das physikalische Bild eines Weizenfelds, das sich unter der Krafteinwirkung des Windes biegt (strukturelle Veränderung auf kurzer Zeitskala), sich danach aber wieder genau wie zuvor aufrichtet. Das System toleriert den Schock, geht daraus jedoch unverändert hervor – es erfährt keine qualitative Steigerung seiner Leistungsfähigkeit.
Antifragilität – wenn Störungen das System besser machen
Ein fragiles System wird durch Belastung schlechter. Ein robustes System hält Belastung bis zu einer gewissen Grenze aus. Ein resilientes System kann sich bei einer Störung in einem gewissen Rahmen an veränderte Bedingungen anpassen, um sich anschließend wieder dem Ausgangszustand anzunähern.
Aber es gibt noch eine weitere Möglichkeit:
Ein System kann durch Belastung besser werden.
Für diese Eigenschaft prägte der Mathematiker, Risikoforscher und ehemalige Derivatehändler Nassim Nicholas Taleb den Begriff Antifragilität. [Taleb2018] Er suchte nach einer Bezeichnung für Systeme, die nicht nur widerstandsfähig gegenüber Volatilität, Unsicherheit und Stress sind, sondern davon profitieren. Denn das eigentliche Gegenteil von fragil ist nicht robust.
Fällt eine Porzellantasse auf den Boden, zerbricht sie. Sie ist fragil. Eine massive Stahltasse übersteht den Sturz vielleicht unverändert. Sie ist robust. Das wirkliche Gegenteil der Porzellantasse wäre aber eine Tasse, die nach jedem Sturz ein wenig stabiler würde.
Antifragile Systeme nutzen Disruptionen, Fehler und Chaos als Katalysatoren für die eigene Weiterentwicklung und erreichen nach einer Krise ein höheres, leistungsfähigeres Niveau als zuvor (Superkompensation). Sie überleben Ungewissheit nicht nur unbeschadet, sondern werden durch sie besser
Was zunächst paradox klingt, ist in der Natur keineswegs ungewöhnlich.
Unser Körper ist voller Systeme, die Belastung benötigen, um leistungsfähig zu bleiben. Muskeln wachsen nicht dadurch, dass wir sie möglichst vollständig vor Belastung schützen. Sie reagieren auf einen angemessenen Trainingsreiz mit Anpassung. Knochen werden durch mechanische Belastung zum Umbau angeregt. Das Immunsystem entwickelt seine Leistungsfähigkeit durch die Auseinandersetzung mit seiner Umwelt.
In der Biologie findet sich dafür unter anderem das Konzept der Hormesis: Eine moderate Belastung kann adaptive Prozesse auslösen, die einen Organismus anschließend leistungsfähiger oder widerstandsfähiger machen. Zu starke Belastung wirkt dagegen schädlich. Antifragilität bedeutet deshalb keineswegs, dass beliebig viel Stress gut wäre. Entscheidend sind Art, Intensität und Dauer der Belastung.
Das ist ein wichtiger Unterschied.
Antifragile Systeme brauchen keine Katastrophen. Sie brauchen Variation, Irritation und ausreichend kleine Belastungen, an denen sie sich entwickeln können.
Noch deutlicher wird das auf der Ebene der Evolution.
Evolution versucht nicht, eine perfekte Lösung für eine vorhersehbare Zukunft zu entwerfen. Sie erzeugt Variation. Unterschiedliche Varianten treffen auf unterschiedliche Umweltbedingungen. Manche bewähren sich, andere verschwinden. Veränderung, Zufall, Selektionsdruck und das Scheitern einzelner Varianten sind keine Störungen dieses Prozesses – sie sind ein wesentlicher Bestandteil davon.
Gerade deshalb können sich lebende Systeme unter veränderlichen Umweltbedingungen über lange Zeiträume weiterentwickeln. Auch in der aktuellen Forschung wird Antifragilität inzwischen als möglicher übergreifender Begriff diskutiert, um zu beschreiben, wie biologische und ökologische Systeme unter bestimmten Bedingungen von Umweltvariabilität profitieren können.
Und damit sind wir wieder bei komplexen Systemen.
Denn Unternehmen – insbesondere wissensintensive Deep-Tech-Unternehmen – sind keine Maschinen.
Sie bestehen aus Menschen, Technologien, Wissen, Beziehungen, Routinen, Entscheidungsprozessen und zahllosen formellen wie informellen Abhängigkeiten. Sie lernen, verändern sich und reagieren auf ihre Umwelt. Neue Ideen entstehen, Menschen verlassen das Unternehmen, Technologien entwickeln sich weiter, Kunden ändern ihre Anforderungen und Wettbewerber treffen Entscheidungen, die niemand vorhersehen konnte.
Der Versuch, eine solche Organisation vollständig zu kontrollieren und ihre Zukunft möglichst exakt vorauszuplanen, stößt deshalb zwangsläufig an Grenzen.
Führung – ein Rahmen statt ein perfekter Plan
Genau deshalb ist Antifragilität in der VUCA/BANI-Welt für Unternehmen keine Option mehr, sondern die essentielle Bedingung für das langfristige Überleben. [Krings-Klebe2025] Wer versucht, das Chaos durch starre Strukturen zu bändigen, erhöht nur seine eigene Fragilität. [Taleb2018] Nur Unternehmen, die dezentrale Strukturen etablieren, bewusste Redundanzen zulassen und durch ein Portfolio konvexer Experimente – kleine, kontrollierte Versuche mit begrenztem Risiko und offenem Erfolgspotenzial – kontinuierlich lernen, können Störungen als Treibstoff nutzen, um gestärkt aus jeder Krise hervorzugehen. [Krings-Klebe2025]
Denn Resilienz macht eine Organisation nach einem Schock wieder funktionsfähig – mehr nicht. Antifragilität verändert damit, was wir von Führung erwarten dürfen. Eine Organisation, die aus Störungen lernen und daran wachsen soll, wird nicht dadurch geführt, dass jemand an der Spitze die Zukunft zuverlässig vorhersagt und einen perfekten Plan liefert. Führung besteht stattdessen darin, einen Rahmen zu schaffen, in dem die Organisation Abweichungen früh bemerkt, daraus lernt und sich weiterentwickelt – statt sie zu verdrängen oder auszusitzen.
Wir müssen Unsicherheit nicht vollständig beherrschen. Wir müssen Organisationen so gestalten, dass sie von einem gewissen Maß an Unsicherheit profitieren können.
Wie ein solcher Rahmen konkret aussieht, ist keine triviale Frage. Wie viel Freiraum zum Experimentieren verträgt ein Team? Wie geht eine Organisation mit einem Fehler um, wenn er tatsächlich passiert? Und woran erkennt man den Unterschied zwischen einem Experiment, aus dem man lernen soll, und einem Risiko, das man sich schlicht nicht leisten kann?
Genau darum geht es im nächsten Artikel dieser Serie. Denn in einer komplexen Welt lässt sich Innovation nicht mehr rein planend herbeiführen – Experimentieren und Scheitern sind notwendiger Teil des Prozesses. Wer daraus systematisch lernen will, statt Fehler zu vermeiden oder zu bestrafen, muss dafür bestimmte Voraussetzungen schaffen. Welche das sind, zeigt der nächste Beitrag.
Ob die eigene Organisation heute näher an fragil, robust, resilient oder antifragil ist – und was sich ändern müsste, damit Störungen nicht nur überstanden, sondern genutzt werden –, lässt sich nicht pauschal beantworten, sondern nur im Blick auf die konkrete Situation. Das ist ein guter Ausgangspunkt für ein Gespräch.
Quellen
- [Pisar2026] Thomas Pisar: Komplexität als Stärke: Wie antifragile Organisationen mit Disruptionen besser werden (2026)
- [Krings-Klebe2025] Janka Krings-Klebe und Jörg Schreiner: Antifragile Organization: From hierarchies to ecosystems (2025)
- [Taleb2018] Nassim Nicholas Taleb: Antifragilität: Anleitung für eine Welt, die wir nicht verstehen (2018)